온보드 다중 카메라: FPGA/MPSoC가 엣지에서 실시간 AI 추론을 구동하는 방법
한 대의 엣지 게이트웨이드가 4~8대의 카메라를 처리하고자 할 때, 8 TOPS CPU/GPU는 배터리·열·비용을 한참 초과하며, 클라우드로 raw 영상을 전송하는 것도 대역폭과 레이턴시가 부담이다. 올바른 패러다임은 FPGA/MPSoC에 온보드 파이프라인을 두어, ISP 전처리, 프레임 디큐, 경량 추론, 결과 필터링을 엣지에서 모두 끝내는 것이다. 이 글에서는 다채널 파이프라인 구조와 FPGA/MPSoC의 역할, 그리고 비용/전력 예산을 계산한다.
1. 왜 온보드 다채널 추론인가
클라우드와 CPU/GPU 접근의 병목은 명확하다:
- 대역폭: 4대의 1080p30 카메라 raw는 약 8×1080×1920×30×24bit ≈ 1.8 Gb/s (H.264로 압축해도 8~12 Mb/s × 4 = 32~48 Mb/s, 업로드 지속 부담)
- 레이턴시: 사고 감지부터 경보까지 클라우드 왕복은 200~500ms, 산업 제어·보안 문맥에서 너무 김
- 전력과 비용: 8 TOPS GPU는 30~60W, 산업용 엣지 박스에 들어가면 방열이 골칫거리, 카메라당 BOM이 올라감
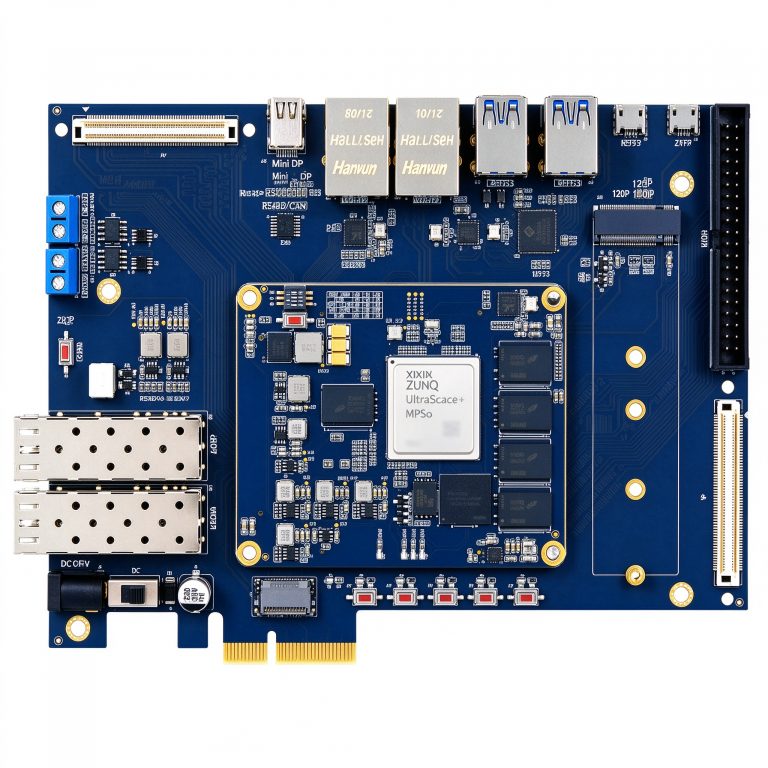
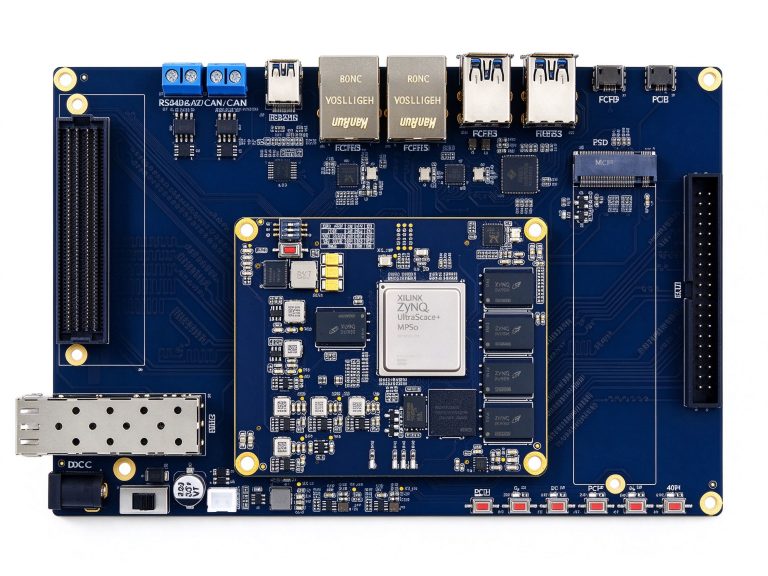
FPGA/MPSoC 접근의 가치: ISP(RAW→RGB), 디큐 버퍼링, 다채널 트래픽 스케줄링, 경량 CNN 추론, 결과 필터링을 한 칩에서 결정론적으로 수행, 호스트는 이벤트 결과(메타데이터)만 받는다.
2. 다채널 온보드 파이프라인 구조
<div class=”case”>
한 대의 엣지 노드에서 여러 카메라를 처리하는 전형적인 구조:
- MIPI CSI-2 수신: 카메라 모듈(OV9281, IMX219 등)이 MIPI D-PHY로 FPGA/MPSoC MIPI 수신 IP에 연결—채당 1~2 레인, 1.5 Gbps/레인.
- ISP 전처리: 온칩 ISP 또는 라이브러리: 디모자이킹, 감마, 화이트 밸런스, 노이즈 감소—RAW Bayer를 RGB/YUV로 변환.
- 프레임 버퍼링: 외부 DDR3/4에 프레임을 쓰고, 추론 엔진이 읽어가며, 이벤트 기반 트리거 시 프레임 캡처.
- 경량 CNN 추론: MobileNet-YOLO, PPYOLO-tiny 등 경량 모델을 FPGA 로직 또는 NNU 가속 IP에 매핑—채당 프레임률 5~15 fps.
- 후처리와 이벤트: 검출 박스, 분류 라벨, 트래킹 ID를 호스트에 전달, 이벤트만 업로드—raw 영상은 전송하지 않음.
</div class=”case”>
채널 수와 프레임률의 관계
| 채널 수 | 해상도 | 총 입력 데이터 | 추론 목표 프레임률 | 요구 FPGA 리소스 |
|---|---|---|---|---|
| 4 | 1080p30 | 4 × 1080p30 ≈ 1.9 Gb/s raw (ISP 후 ≈ 60 MB/s RGB) | 채당 10 fps | MPSoC 중급 (ZU7EV급) |
| 8 | 720p30 | 8 × 720p30 ≈ 1.6 Gb/s raw | 채당 8 fps | MPSoC 상급 (ZU19EG급) 또는 FPGA + NNU |
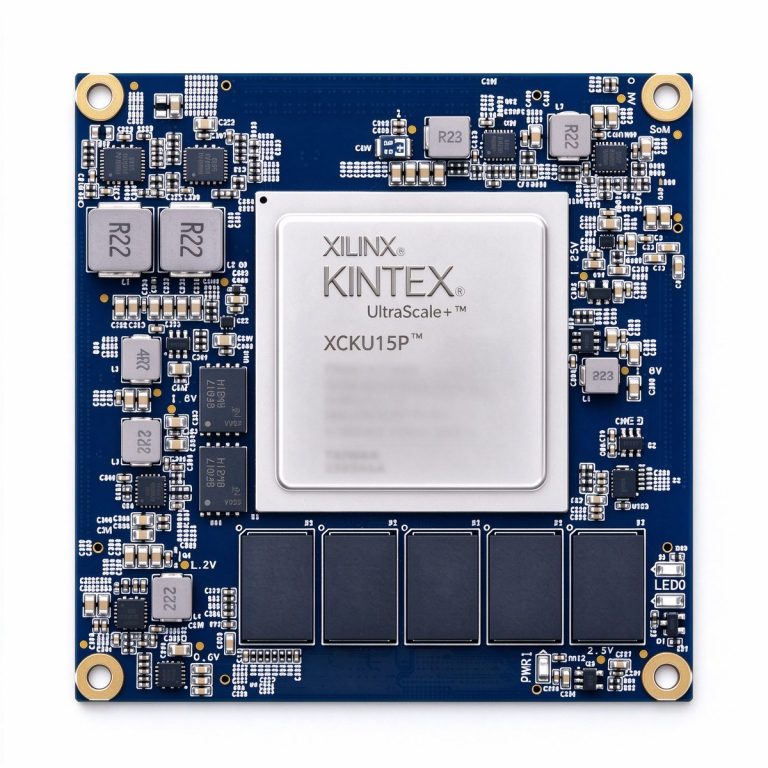
| 16 | 480p30 | 16 × 480p30 ≈ 1.2 Gb/s raw | 채당 5 fps | FPGA 중고급 (XCKU15P급) |
핵심 결론: raw 영상 전체가 아니라 이벤트 메타데이터만 업로드—클라우드 왕복 대역폭과 레이턴시를 1/10~1/100로 줄이고, 엣지 노드 자립도를 높인다.
3. FPGA/MPSoC가 온칩에서 하는 일
1. MIPI 수신과 타이밍 정렬
다중 카메라의 MIPI 클록은 독립적이다. FPGA/MPSoC는 채별 수신 버퍼와 동기화 로직을 두어, 매 프레임의 VSYNC 기준을 정렬하고, 추론 스케줄러가 채별로 읽어간다. 여기서 가장 흔한 실수: 단일 클록으로 다중 카메라를 정렬하려다 메타스테이블리티로 크로스채널 아티팩트 발생.
2. ISP와 전처리 가속
디모자이킹, 3A(AWB/AE/AF) 통계, 노이즈 감소는 결정론적 파이프라인으로 FPGA에 최적이다. MPSoC는 하드 ISP 블록을 갖춘 제품도 있어 소프트웨어 부하를 크게 줄인다.
3. 추론 엔진 가속
경량 CNN은 보통 CONV + POOL + FC 층으로 구성되며, FPGA는 CONV를 병렬 곱누적으로 가속한다. MPSoC NNU(Neural Network Unit)는 전용 하드웨어로 MobileNet/YOLO-tiny를 채당 10 fps 이상 돌린다. 중요: 모든 채널에 동일 프레임률을 요구하지 말라—트리거 기반으로 조건부 추론을 섞어 리소스를 아낀다.
4. 결과 필터링과 호스트 인터페이스
추론 결과를 on-chip에서 필터링: 임계값 이하 검출은 버리고, 관심 클래스만 호스트에 이벤트로 보낸다. 호스트는 영상 스트림을 직접 다루지 않고 이벤트 구독만 하므로 CPU 부하가 극도로 낮다.
4. 전력·비용 예산 사례
4채널 1080p30 + 채당 10 fps 추론을 설계한다고 가정하자:
| 구성 | 전력 | BOM 대략 | 적합 상황 |
|---|---|---|---|
| X86+8 TOPS GPU 엣지 박스 | 35~60W | ¥8,000~12,000 | 범용, 복잡 모델 |
| MPSoC (ZU7EV급) 온보드 | 5~10W | ¥1,500~2,500 | 4채널 이하, 경량 모델, 산업용 엣지 |
| FPGA (XCKU15P급) + 외부 DDR | 8~15W | ¥3,000~5,000 | 8채널 이상, 사용자 정의 ISP/추론 |
엣지 AI 시장에서 “충분한 추론”이란 최고 모델이 아니라 필요한 채널·프레임률을 열·전력 예산 안에서 돌리는 것이다. FPGA/MPSoC는 결정론적 레이턴시, 낮은 전력, 하드웨어 재설정 유연함을 제공한다.
5. 엔지니어링 함정
- MIPI 클록 스큐: 다중 카메라 배선 길이 차이가 크면 CSI-2 수신이 불안정해진다—배선 매칭 또는 재클록 버퍼를 쓸 것.
- DDR 대역폭 부족: 4채널 ISP + 추론이 동시에 DDR을 읽으면 32-bit DDR3로는 부족—DDR4 폭·클록을 초기 사이징에 포함할 것.
- 모델 크기 vs 온칩 메모리: 경량 모델도 가중치를 BRAM에 다 담을 수 없다—외부 DDR에서 스트리밍하거나 층별 파이프라인으로 분할할 것.
- 발열: 10W FPGA/MPSoC도 밀폐 enclosure에서는 85°C 산업 등급 마진이 빠듯하다—히트싱크 또는 팬을 초기 설계에 포함.
온보드 다중 카메라 엣지 AI는 raw 영상을 클라우드에 보내는 문제를, 엣지에서 파이프라인 전체를 돌려 이벤트만 남기는 문제로 바꾼다. FPGA/MPSoC의 진짜 가치는 최고 TOPS가 아니라 결정론적 타이밍, 낮은 전력, 그리고 채널 수와 프레임률을 예산 안에서 맞추는 유연함에 있다.