VU13P 정량 거래: 시세 데이터 디코딩부터 주문 실행까지 초저지연 하드웨어 플랫폼
퀀트 거래의 본질은 “시세 데이터 도착 → 신호 연산 → 주문 전송”의 정보 루프를 최단 시간에 완성하는 것이다. 이 글은 AMD Virtex UltraScale+ XCVU13P (VU13P) 플랫폼을 주선으로, 왜 퀀트 거래에 맞는지와 이를 납품 가능한 저지연 거래 체인으로 배치하는 방법을 설명한다.
퀀트 거래의 본질은 “시세 데이터 도착 — 신호 연산 — 주문 전송”의 정보 루프를 최단 시간에 완성하는 것이다. 거래소 매칭 엔진의 마이크로초 타임스케일에서 레이턴시 자체가 비용이다: 1 마이크로초 늦으면 가격 슬리피지, 기회 상실, 또는 전략 전체의 실패를 의미한다. 지난 10년간 선두 프로프라이어터리 트레이딩사는 체인의 가장 결정적인 부분을 CPU 소프트웨어에서 FPGA 하드웨어로 점진 이전해 왔다—카드 위 시세 디코딩, 카드 위 오더북, 카드 위 전략 결정, 카드 위 주문 생성. 이 글은 AMD Virtex UltraScale+ XCVU13P (VU13P) 플랫폼을 주선으로, 왜 퀀트 거래에 맞는지와 이를 납품 가능한 저지연 거래 체인으로 배치하는 방법을 논한다.
1. 퀀트 거래의 레이턴시 구조: 왜 답이 FPGA인가
전형적 자동 거래 체인—시세 패킷이 NIC에 도착해 주문이 NIC를 떠나기까지—은 네트워크 스택, 시세 파싱, 오더북 유지, 신호 연산, 리스크 체크, 주문 인코딩을 순차적으로 통과한다. 소프트웨어 스택에서는 커널 인터럽트, 프로토콜 스택 처리, 스레드 스케줄링, 캐시 미스가 모두 제어 불가능한 지터를 도입; 하드웨어 구현은 이 단계를 고정 파이프라인 깊이로 바꿔 결정적 레이턴시, 인터럽트 없음, 스케줄링 없음을 만든다. 구현 방식별 대략적 종단간 tick-to-trade 레이턴시:
표: 종단간 tick-to-trade 레이턴시 비교 (공개 자료 편집)
| 구현 | 전형적 종단간 레이턴시 |
|---|---|
| 일반 소프트웨어 + 커널 네트워크 스택 | 10–100 µs |
| 커널 바이패스 소프트웨어 (DPDK / Onload + 코어 고정) | 1–5 µs |
| 전체 FPGA 체인 (파싱 → 전략 → 주문) | 300 ns – 1 µs |
| FPGA 사전 무장 트리거 (패턴 매치와 전송) | 30–100 ns |
| 1계층 스위치 (순수 팬아웃/복제) | 약 5 ns |
FPGA의 세 가지 속성이 이 자릿수 차이를 결정한다: 병렬성—여러 시세 피드와 전략 인스턴스가 하드웨어에서 동시에 경쟁 없이 구동; 결정성—인터럽트나 스케줄링이 없어 각 패킷 처리 레이턴시가 고정, 리스크 제어와 감사에 동등하게 중요; 근접성—광 포트가 FPGA에 직접 연결되어 PCIe와 프로토콜 스택을 우회하고, 패킷이 도착하자마자 디코딩한다. 업계 공개 데이터가 이를 확인한다: 어떤 솔루션은 왕복 tick-to-trade 레이턴시 100 ns 미만을 광고하고, AMD의 CME용 파트너 참조 설계는 사전 무장 트리거 레이턴시 25 ns급을 달성; 2025년 *Computer Applications and Software*의 OpenCL 기반 초저지연 시세 가속 시스템 논문은 Alveo U50에서 최소 678 ns 시세 처리, 38.4 Gbit/s 스루풋을 달성해 소프트웨어 방식 대비 약 12배 성능 향상을 이뤘다.
2. VU13P 플랫폼 능력 개요
VU13P는 AMD Virtex UltraScale+ 계열에 속하며 “로직 규모 × 고속 인터페이스” 균형점의 대표 디바이스다. AMD 공식 제품 문서에 따르면 주요 스펙은 다음과 같다:
표: XCVU13P 주요 스펙 (출처: AMD 공식 Virtex UltraScale+ 제품 페이지)
| 지표 | XCVU13P 사양 |
|---|---|
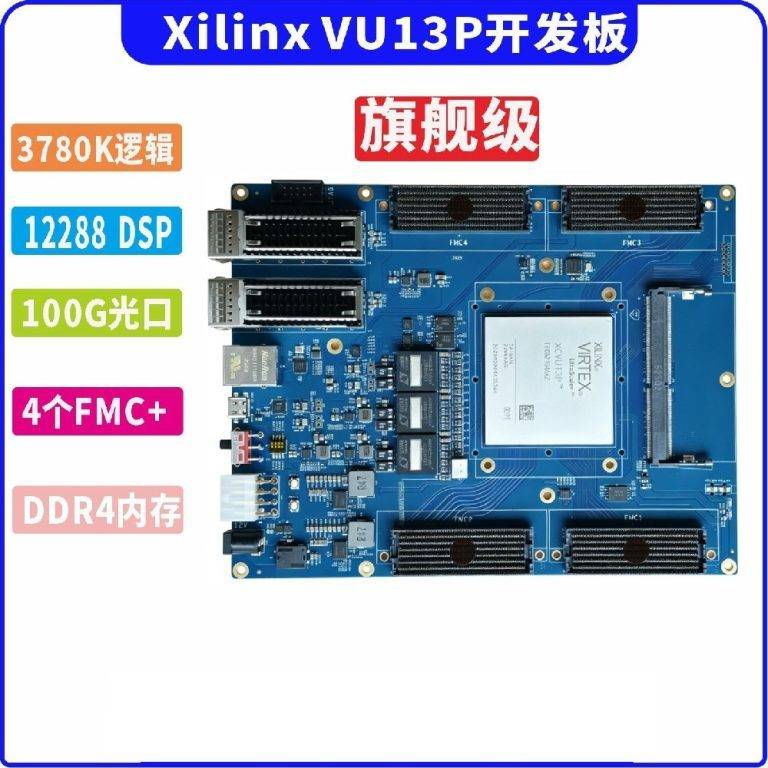
| 시스템 로직 셀 | 3,780K (약 378만 로직 셀) |
| DSP 슬라이스 | 12,288 |
| GTY 고속 트랜시버 | 128 페어 (페어당 최대 32.75 Gb/s) |
| 사용자 I/O | 832 |
| 집적 고속 인터페이스 | PCIe Gen3 x16, 100G 이더넷 MAC, 150G Interlaken (다이 내 하드 블록) |
| DSP 연산 | 최대 약 38 TOP/s |
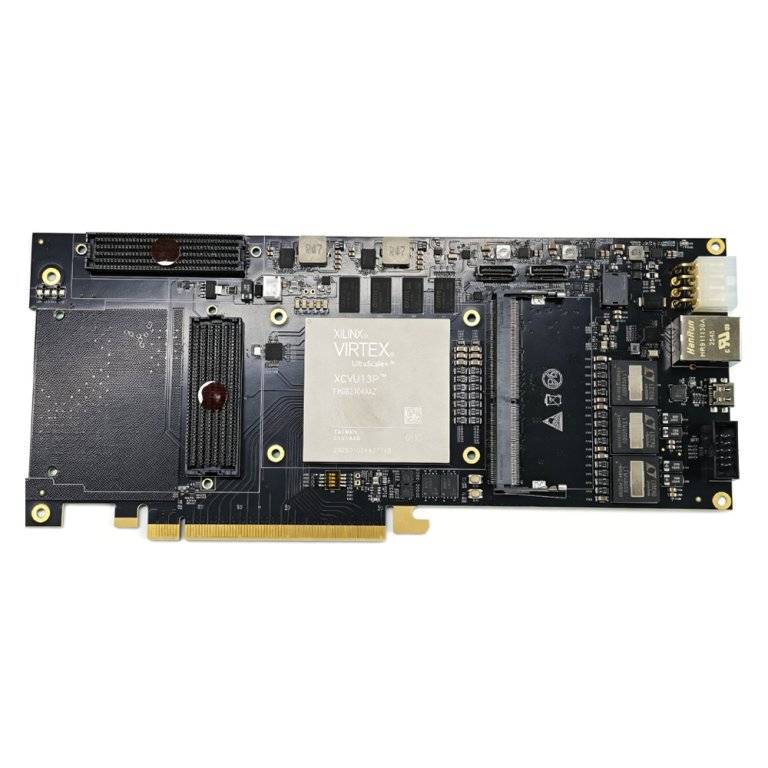
보드 레벨에서 Duyuan Electronics의 VU13P 초고급 개발 플랫폼은 PCIe Gen3 x16 골드 핑거, 다수의 100G 광 포트 (QSFP28), FMC+ 고속 확장, DDR4 SODIMM 확장, 산업용 −40°C~85°C 온도 범위를 제공한다. 퀀트 거래에 이 보드는 자연스럽게 세 가지를 준다: 여러 거래소 피드를 FPGA에 직접 연결(광 포트 + GTY), 상당한 전략 로직을 FPGA 안에 배치(378만 로직 셀 + 12,288 DSP), 고대역폭 양방향 호스트 상호 연결(PCIe Gen3 x16).
3. VU13P의 퀀트 거래 체인 4대 핵심 응용
3.1 시세 데이터 디코딩과 전처리 (Feed Handler)
거래소 시세 프로토콜(NASDAQ ITCH, CME MDP3, 유럽 거래소가 흔히 쓰는 FAST 형식 등)은 극도로 높은 패킷 레이트로 도착; 소프트웨어 파싱은 패킷당 디코딩, 검증, 구조 재구성을 요구해 체인에서 가장 먼저 그리고 가장 전형적인 병목이다. VU13P에서 시세 파싱은 하드웨어 파이프라인으로 구현된다: 패킷이 광 포트에 들어오자마자 바이트 스트림으로 디코딩되고, 필드 추출, 검증, 프로토콜 재조립이 고정 파이프라인 단계 내에서 완료되며, 여러 피드(여러 거래소, A/B 주예비 라인)가 병렬 처리된다. 128 GTY 트랜시버와 다수의 100G 광 포트가 충분한 동시 연결 용량을 제공; 주예비 이중 라인으로 발표하는 거래소(CME의 A/B 라인 등)에 대해 라인 중재와 무중단 페일오버를 하드웨어로 구현해 단일 라인 지터로 인한 시세 공백을 피한다. 파싱된 표준 시세 구조는 호스트 CPU를 거치지 않고 온칩 저장소에 직접 쓰여 다운스트림 전략 모듈로 간다.
3.2 하드웨어 오더북과 병렬 전략 실행
조회 가능한 오더북 유지는 빈번한 삽입, 삭제, 수정, 정렬 연산을 요구; 소프트웨어 구현은 메모리 접근과 락에 의존하는 반면 하드웨어 구현은 가격 레벨을 온칩 Block RAM 구조에 직접 매핑하고 가격 조회와 매칭 결정을 고정 사이클로 완료한다. 이를 바탕으로 VU13P의 378만 로직 셀은 단일 디바이스에서 여러 전략 인스턴스가 병렬 구동을 허용한다: 다른 상품, 다른 시장, 심지어 다른 전략 로직(호가, 크로스마켓 차익, 레이턴시 차익, 통계 회귀)이 독립 로직 파티션을 차지해 동일한 파싱 시세 스트림을 간섭 없이 공유한다. 레이턴시 민감 트리거 전략에는 “사전 무장 주문” 방식을 쓸 수 있다: 주문 템플릿을 미리 송신 버퍼에 쓰고, 하드웨어가 설정 조건(가격 돌파, 거래량 비율 변화)을 감지하면 직접 전송을 트리거해 소프트웨어 결정 경로를 우회하고 레이턴시를 수십 나노초로 압축한다.
3.3 사전 거래 리스크
거래소와 컴플라이언스 프레임워크는 알고리즘 거래에 점점 엄격한 리스크 요건을 부과한다: 가격 밴드, 주문당 수량 상한, 누적 일일 포지션, 주문 빈도 등의 체크가 주문 발송 전에 완료되어야 한다. 소프트웨어 리스크 체크의 문제는 크리티컬 패스 위에 놓여 레이턴시를 더한다는 것; FPGA 리스크 체크는 체크 로직을 주문 경로와 병렬로 둔다—모든 주문이 하드웨어 파이프라인의 여러 리스크 체크 단계를 통과하고, 승인되면 즉시 인코딩되어 발송, 거부되면 나노초에 차단. 리스크 규칙은 레지스터/메모리 테이블로 설정되고 거래일 내 핫 업데이트 가능해 주경로의 저지연을 희생하지 않고 컴플라이언스 요건을 만족한다.
3.4 백테스팅, 시뮬레이션, R&D 가속
생산 체인 너머 VU13P의 큰 로직 리소스는 전략 R&D도 지원한다: 개발 보드에 시세 리플레이와 시뮬레이션 엔진을 올려 하드웨어급 백테스트를 과거 데이터에 대해 병렬 수행—소프트웨어 시뮬레이션보다 훨씬 빠르고; Vivado/Vitis HLS로 C/C++ 알고리즘을 빠르게 하드웨어 구현에 매핑해 “전략 아이디어 → 테스트 가능한 하드웨어” 반복 주기를 단축한다. 전형적 엔지니어링 구성은 “FPGA가 생산 경로를, CPU가 모니터링과 분석을”이다: 생산 주문과 시세 처리는 전부 카드에서 일어나고, 호스트는 PCIe Gen3 x16으로 상태를 읽고 전략 파라미터와 리스크 규칙을 내려보내 성능과 운영의 균형을 맞춘다.
4. 전형적 종단간 시스템 아키텍처
VU13P 기반 퀀트 거래 플랫폼의 전형적 토폴로지는 다음과 같다:
- 시세 인그레스: 거래소 피드가 100G 광 포트(QSFSP28)를 통해 FPGA에 직접 진입, 128 GTY 페어가 여러 라인을 캐리;
- 하드웨어 파싱: Feed Handler 모듈이 프로토콜(ITCH/FAST/MDP3 등)에 따라 파이프라인으로 A/B 라인을 디코딩·검증·중재;
- 오더북과 신호: 온칩 BRAM이 여러 상품의 오더북을 유지, 전략 파티션이 병렬로 신호를 연산, 트리거 조건 충족 시 주문 생성;
- 리스크와 인코딩: 주문이 사전 거래 리스크 체크를 통과하고 거래소 프로토콜 메시지로 인코딩된 뒤 송신 버퍼로 진입;
- 호스트 상호 연결: 주문 확인, 체결 보고, 상태 모니터링이 PCIe Gen3 x16으로 호스트에 전송; 전략 파라미터와 리스크 규칙이 호스트에서 내려옴;
- 확장 인터페이스: FMC+는 커스텀 NIC/가속 메자닌 카드 연결에, OCULINK는 보드간 고속 상호 연결에 쓰여 다보드 스케일링을 지원.
배치 형태에서 VU13P 개발 보드는 서버 내 PCIe 가속 카드로 직접 쓰일 수 있고; 랙 공간과 전력에 민감한 시나리오에는 이 플랫폼을 바탕으로 저전력 코어 보드 폼팩터를 커스텀할 수 있다.
5. VU13P가 다른 방식보다 나은 엔지니어링 우위
표: 퀀트 거래 하드웨어 플랫폼 비교 관점
| 차원 | VU13P (FPGA) 상대 우위 |
|---|---|
| 종단간 레이턴시 | 전체 체인 300ns–1µs, 사전 트리거 30–100ns; 소프트웨어 방식은 보통 1–100µs |
| 레이턴시 결정성 | 고정 파이프라인 깊이, 인터럽트/스케줄링 지터 없음, 리스크와 감사에 적합 |
| 병렬 용량 | 3,780K 로직 셀 + 12,288 DSP, 여러 전략/상품 동시 처리 |
| 인터페이스 대역폭 | 128×GTY, 다수 100G 광 포트, PCIe Gen3 x16, 다거래소 피드 직결 |
| 유연성 | 재구성 가능: 전략 변경이 설정/리로드, 보드 교체 불필요; 개발 주기가 ASIC보다 훨씬 짧음 |
| 개발 문턱 | ASIC보다 낮음; Vitis HLS/OpenCL이 C/C++에서 매핑, 핵심 경로는 RTL로 추가 최적화 |
CPU와 비교: VU13P는 레이턴시와 결정성에서 자릿수 앞선다; GPU와 비교: GPU는 배치 스루풋에 강하지만 파이프라인과 스케줄링이 레이턴시 지터를 도입해 나노초 결정 경로에 부적합하며, VU13P의 결정적 레이턴시가 자연스럽게 맞는다; ASIC과 비교: ASIC은 성능이 최고지만 일회 비용과 개발 주기가 너무 커 완전히 얼어붙은 알고리즘에만 적합하고, VU13P는 전략 진화의 유연성을 유지한다. 이래서 프로프라이어터리 트레이딩사가 “결정 경로는 FPGA, 리서치와 오프라인 연산은 CPU/GPU”를 표준 분업으로 널리 쓴다.
6. 개발과 배치 핵심 요령
- 툴체인 분업: 결정 경로(프로토콜 파싱, 주문 인코딩)는 RTL로 레이턴시 보장; 전략 로직은 Vitis HLS/OpenCL로 빠르게 구현해 소프트웨어 시뮬레이션에서 동작을 먼저 검증한 뒤 하드웨어로 합성;
- 모듈 인터페이스: Feed Handler, Order Book, Strategy, Risk, Gateway는 AXI-Stream 데이터 인터페이스를 공통으로 써 교체·재사용·팀 협업을 쉽게;
- 클록과 동기화: 다보드/다사이트 배치에서 PTP/1PPS와 저지터 클록 트리를 도입해 시간 기준을 통일, 체결 보고와 시세 타임스탬프 정렬 보장;
- 표준 보드에서 시작: 먼저 VU13P 개발 보드에서 시세 파싱과 전략 검증을 완료하고 레이턴시 체인을 돌린 뒤, 프로젝트 요구에 맞춰 보드 폼팩터(인터페이스 수, 전력, 기계 구조)를 커스텀;
- 모니터링과 회귀: 하드웨어 로직에 통계 카운터와 ILA 관측점을 유지, 거래일 중 단계별 파이프라인 레이턴시를 모니터링해 저하가 있으면 빠르게 위치 추적.
7. 한계와 선택 권고
FPGA가 모든 퀀트 시나리오의 답은 아니다. 전략이 분·시간 단위로 리밸런싱하거나 복잡한 모델의 빈번한 반복을 수반하는 대규모 머신러닝 피처에 의존하면 CPU/GPU 소프트웨어 스택의 비용과 유연성 우위가 더 뚜렷; 팀에 하드웨어 개발 능력이 없다면 FPGA 프로젝트의 평가·디버깅·유지보수 주기를 충분히 감안해야 한다. 하드웨어 저지연이 요건으로 확인되면 리소스 요구에 따라 디바이스를 계층 선택할 수 있다:
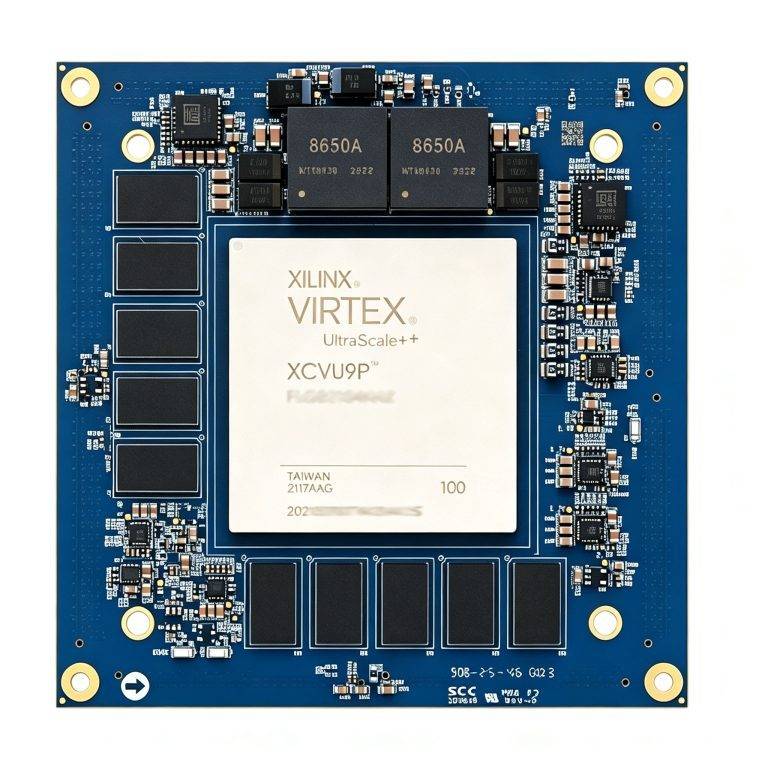
- VU9P: 2,586K 로직 셀, 6,840 DSP, 2×200G + 4×100G 광 포트, 32GB DDR4 ECC, PCIe x16—큰 시세 인그레스와 스토리지/대역폭 중시 시나리오에 적합;
- VU13P: 3,780K 로직 셀, 12,288 DSP, 128×GTY—병렬 다전략, 복잡한 전략 로직, 더 많은 온칩 리소스가 필요한 시나리오에 적합; 이 응용 계열의 종합 주력 플랫폼;
- VU13F: 12,288 DSP 동일, 4×FMC+로 광범위한 확장 I/O와 메자닌 카드 인터페이스 제공—커스텀 NIC, RF 프론트엔드 등 외부 하드웨어를 요하는 시스템급 통합에 적합.
참고: 이 글의 레이턴시 수치는 공개 자료의 전형 범위; 실제 값은 프로토콜, 패킷 레이트, 전략 구현, 보드 배선에 따라 달라진다. 선택과 인수는 현장 측정을 기준으로 해야 한다.
8. 결론
퀀트 거래의 하드웨어화는 수년째 확정된 추세다: 초기 NIC 오프로드에서 시세 파싱과 전체 주문 체인을 FPGA로 옮기고, 오늘날 단일 VU13P급 디바이스가 다시장 데이터, 다전략, 리스크 제어를 동시에 캐리한다. VU13P의 가치는 “규모”와 “속도”를 같은 디바이스에 두는 데 있다—복잡한 전략 조합이 하드웨어에서 병렬 구동할 충분한 로직과 DSP, 다거래소 인그레스가 더 이상 병목이 아닐 충분한 GTY와 100G 광 포트. Duyuan Electronics는 VU13P/VU9P 표준 개발 보드, 커스텀 코어 보드, 시세 디코딩과 저지연 체인 IP 패키지, 종단간 기술 지원을 제공해 팀이 평가 보드 검증에서 배치 가능한 퀀트 거래 하드웨어 플랫폼으로 빠르게 나아가도록 돕는다.
참고문헌
- AMD, Virtex UltraScale+ FPGA 제품 페이지 (XCVU13P 스펙): https://www.amd.com/en/products/adaptive-socs-and-fpgas/fpga/virtex-ultrascale-plus.html
- AMD/Xilinx with LDA, CME Tick-to-Trade 25 나노초 참조 솔루션: https://www.xilinx.com/publications/solution-briefs/partner/xilinx-lda-amd-tick-to-trade-solution-brief.pdf
- libfpga, FPGAs in high-frequency trading: the anatomy of a nanosecond (tick-to-trade 레이턴시 비교): https://libfpga.com/blog/fpgas-for-hft
- semidesignjobs, FPGAs in High-Frequency Trading: A Technical Deep Dive: https://www.semidesignjobs.com/blog/fpga-hft-technical-deep-dive
- Enyx, nxFramework (100ns 미만 tick-to-trade 플랫폼): https://www.enyx.com/nxframework/
- Computer Applications and Software 2025, OpenCL 기반 초저지연 시세 가속 시스템 설계와 구현: https://shcas.net/cn/article/doi/10.3969/j.issn.1000-386x.2025.03.003
- ACM, DSL Programmable Engine for High Frequency Trading Acceleration (FAST 프로토콜 가속): https://dl.acm.org/doi/pdf/10.1145/2088256.2088268
Duyuan Electronics · 응용 실천 | 데이터 기준 2026년 9월; 기관별 적용 범위가 다르며 모든 출처 주석 부착