의료 초음파 빔포밍: 128채널 신호 체인과 데이터 레이트 산정
128채널 컬러 초음파 프로브는 채당 12-bit, 40 MS/s ADC로 샘플링해 초당 약 7.7 GB/s의 원시 데이터 레이트를 만들어낸다—CPU가 흡수하기는커녕 실시간 영상화도 불가능한 수준이다. 올바른 접근은 빔포밍, 엔벨로프 검파, 다운샘플링을 FPGA 안에서 먼저 돌리고, 압축된 영상 데이터만 호스트에 넘기는 것이다. 이 글에서는 128채널 체인을 단계별로 분해하고 각 단계의 데이터 레이트를 산정하며, FPGA가 그 사이에서 무엇을 하는지 정확히 설명한다.
1. 초음파 영상화 전체 신호 체인
프로브 어레이에서 화면의 그레이스케일 영상까지, 신호는 긴 체인을 travel하며 FPGA는 아날로그 프론트엔드 직후, 호스트 영상화 전에 위치한다:
- 프로브 어레이 (128 엘리먼트): 초음파를 방사하고 조직 에코를 수신, 각 엘리먼트가 독립 채널에 대응.
- 아날로그 프론트엔드 (AFE): TGC 시간 이득 보상 → 대역 통과 필터 → 가변 이득 증폭 → ADC 디지털화.
- FPGA 빔포밍: 채널당 프로그래머블 딜레이, 가중치 곱산 및 합산으로 스캔 라인을 만들어 동적 포커싱을 완성.
- IQ 복조 + 다운샘플링 + 엔벨로프 검파: 고주파 RF 신호를 진폭 그레이스케일 데이터로 압축.
- 스캔 컨버전 + 프레임 버퍼 + PCIe 업로드: 극좌표 스캔 라인을 직교좌표로 변환하고 호스트로 보내 DSC와 컬러 매핑을 수행.
3·4단계를 FPGA에서 돌려야 하는 이유는 간단하다: 128채널을 마이크로초 단위로 정렬·지연·가중합산해야 하며, 각 지연은 깊이에 따라 동적으로 바뀐다. 이것은 고도로 병렬화된 채널당 결정 타이밍 작업으로, 범용 CPU의 소프트웨어에는 병렬성도 실시간 프레임 레이트도 둘 다 없다.
2. 128채널 데이터 레이트 산정 (연결 전에 계산)
예산은 단일 채널 ADC에서 시작해 위로 곱해 나간다. 12-bit, 40 MS/s ADC를 예로 들면:
| 단계 | 채널당 레이트 | 128채널 합계 | 비고 |
|---|---|---|---|
| ADC 원본 샘플링 | 12 bit × 40 MS/s = 480 Mb/s (60 MB/s) | 128 × 480 = 61440 Mb/s ≈ 61.4 Gb/s (7.68 GB/s) | FPGA로 들어가는 원시 피크 |
| 빔포밍 (지연 합산) | 128채널 가중합산 → 스캔 라인 1개 | 합산 후 더 이상 128 병렬 경로 아님 | 병렬성이 이곳에서 압축됨 |
| IQ 복조 + CIC/FIR 다운샘플 | RF 40 MS/s → ~10 MS/s 복소 등가 | 단일 경로 ~20 MB/s (복소 12-bit) | 데시메이션 후 원본의 1/4 이하 |
| 엔벨로프 검파 + 로그 압축 | 8-bit 진폭, ~10 MS/s | 단일 경로 ~10 MB/s | 다이나믹 레인지를 40–60 dB로 압축 |
| 호스트 PCIe 업로드 | — | 256 라인 × 60 fps × 8 bit ≈ 122 MB/s | CPU가 처리 가능한 수준 |
핵심 결론: 압축은 FPGA 안에서 일어난다. FPGA에 들어가는 것은 61.4 Gb/s 원시 병렬 스트림이고, 호스트로 나가는 것은 약 122 MB/s의 그레이스케일 프레임 데이터뿐이다. 압축 비율이 60배를 넘는다—128경로를 1개로 합치는 빔포밍, 그리고 고주파 RF를 진폭 엔벨로프로 무너뜨리는 다운샘플링과 검파의 결과다. FPGA를 건너뛰고 7.68 GB/s 원본 스트림을 CPU로 밀면 메모리 대역폭도 PCIe도 감당하지 못한다.
프레임 레이트 vs 스캔 라인 수
빔포밍에서 모든 스캔 라인은 새 128채널 지연 합산을 요구한다. 프레임이 N라인을 프레임 레이트 F로 holding한다면, FPGA는 초당 N×F 합산을 완료해야 한다. N=256, F=60 fps이면 초당 15360 스캔 라인이며, 각각 128개의 가중·지연 샘플을 합산한다—FPGA 곱산기(DSP)와 온칩 RAM(딜레이 라인 FIFO) 사이징의 출발점이다.
3. FPGA 내부 체인은 어떻게 나뉘나
1. 동기 수집과 채널 정렬
128채널은 보통 여러 AFE에 걸쳐 JESD204B 또는 병렬 LVDS로 FPGA에 들어온다. 첫 관문은 스큐 보상: 채널별 배선 길이가 달라 FIFO 전에 샘플을 하나의 클록 기준으로 정렬해야 하며, 그렇지 않으면 지연 합산의 위상이 어긋나 사이드로브와 고스팅 아티팩트를 만든다.
2. 동적 포커스 지연 합산
각 엘리먼트는 포커스 포인트까지 거리가 다르므로 에코가 다른 시간에 도착한다. FPGA는 프로그래머블 딜레이 라인(깊이 조절 FIFO 또는 탭딜레이)으로 채널별 시간차를 보상한 뒤 아포다이제이션 가중치를 곱해 합산한다. 포커스 깊이가 시간 게이트에 따라 움직이므로 딜레이 파라미터가 세그먼트마다 갱신되며, 면적 온칩 BRAM과 곱누적용 DSP를 많이 소비한다.
3. IQ 복조, 다운샘플링, 엔벨로프 검파
합산된 RF 라인은 직교 복조(I/Q 믹싱)를 먼저 거치고, CIC + FIR 캐스케이드가 샘플 레이트를 데시메이션한다. 힐버트 변환이 엔벨로프를 찾고 로그 압축이 큰 다이나믹 레인지를 8-bit 그레이스케일로 매핑한다. 이 단계는 전형적인 파이프라인 필터링으로—DSP 활용률은 높지만 병렬성은 낮다.
4. 스캔 컨버전, 프레임 버퍼, 업로드
극좌표 부채꼴 스캔 라인이 직교좌표 직사각 픽셀로 재샘플링되어 DDR3/4 프레임 버퍼에 쓰이고, DMA가 프레임 전체를 PCIe로 호스트에 보낸다. 이 단계는 DSP 스루풋이 아니라 DDR 읽기/쓰기 대역폭과 DMA 엔진이 관건이다.
4. 엔지니어링 사례: 휴대용 컬러 초음파 프론트엔드 사이징
휴대용 컬러 초음파 프론트엔드는 128채널 AFE가 RF를 40 MS/s, 12-bit로 샘플링한다. 빔포밍은 128개 딜레이 라인과 가중 곱산을 병렬로 처리해야 하고, 혈류 도플러 채널이 추가된다. 위 예산대로면 원시 61.4 Gb/s가 FPGA 안에서 약 122 MB/s 그레이스케일 프레임으로 압축되고, PCIe Gen2 x4 순대역폭이 이를 여유롭게 carry한다.
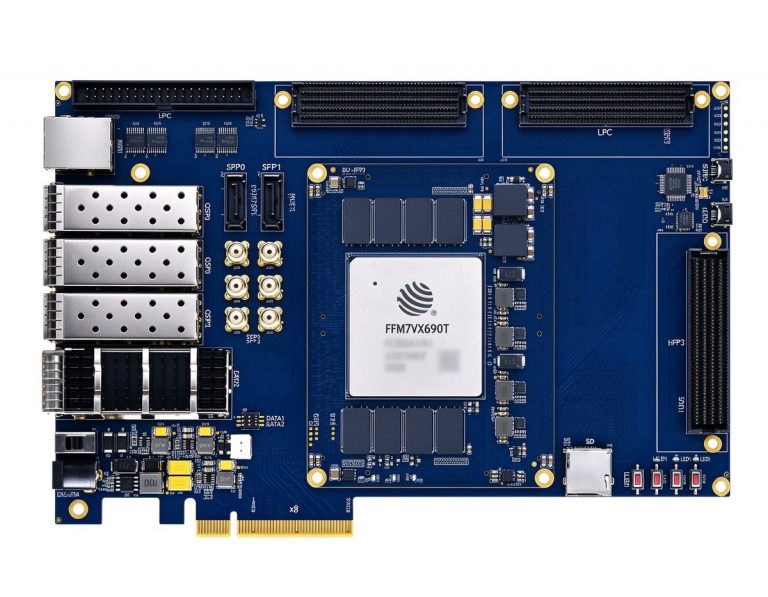
- 고용량 (DUF7690T / JFM7VX690T): 128개 딜레이 라인 FIFO, 그레이스케일 합성, 도플러 채널을 한 번에 holding할 충분한 로직과 온칩 RAM. 풀 128채널·고프레임 설계에 적합.
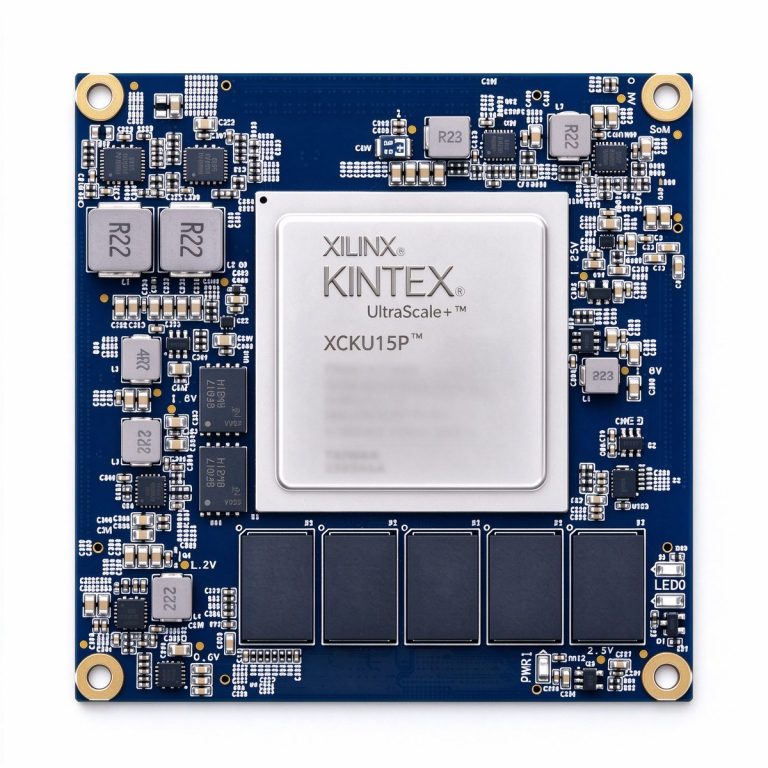
- 고채널 확장 (XCKU15P): 강력한 트랜시버와 다채널 LVDS 집계. 추가 채널 확장이나 AFE 데이터를 광으로 되보내는 분산 프로브에 적합.
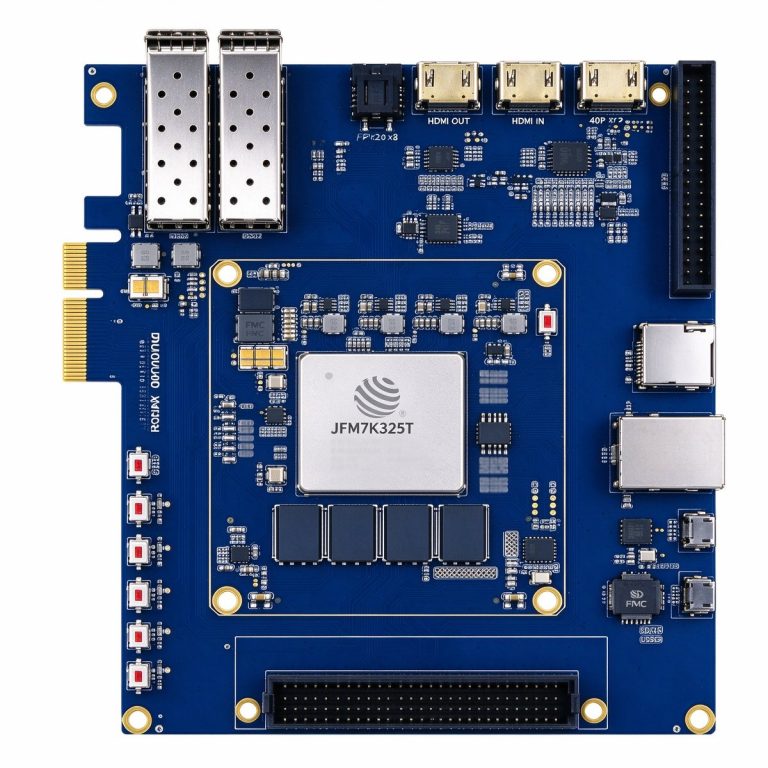
- 미드레인지 엔트리 (DUK7325T / JFM7K325T): 균형 잡힌 리소스와 비용. 64~128채널 그레이스케일 프로토타입과 중저가 제품에 적합—고용량 플랫폼으로 가기 전에 여기서 지연합산·검파 체인을 돌려 본다.
초음파 영상화는 본질적으로 FPGA 안의 병렬 지연합산으로 128개 고속 원시 에코를 단일 스캔 라인으로 바꾸는 일이다. 데이터 레이트 예산이 명확해지면—프론트엔드 61.4 Gb/s, 업로드 122 MB/s—어느 단계를 온칩에 두고 어느 단계를 호스트로 보낼지 알게 된다. 의료 초음파에서 FPGA는 가속 카드가 아니라 영상화 그 자체다.