10G/25G 광 백홀: GTX/GTH 라이트 레이트 설계와 UDP 오프로드
여러 고속 ADC, 레이더 빔, 영상 스트림이 한곳에 모이면 구리 케이블은 수 미터에서 한계고 PCIe는 섀시를 못 나선다. 올바른 백홀은 FPGA의 GTX/GTH 트랜시버로 SFP+/QSFP를 직접 구동하고, MAC과 IP/UDP 스택을 온칩 오프로드해, 페이로드만 라이트 레이트로 광에 실어 보내는 것이다. 이 글에서는 10G/25G 라이트 레이트, UDP 페이로드, 링크 버짓, FPGA 내부 역할 분담을 계산한다.
1. 고속 데이터에 광 백홀이 필요한 이유
보드 안은 PCIe를 쓰고, 짧은 보드간 링크는 구리를 쓰지만, 수집 노드가 분산되면 거리가 수 미터를 넘고 채널당 수 Gbsl 이상이라 구리와 백플레인이 먼저 천장에 부딪힌다:
- 거리 천장: 10G DAC 케이블은 보통 3~5m밖에 지원하지 않고 액티브 구리도 제한적이다. 단일모드 광 + 광 모듈은 손쉽게 10km에 다다라 분산 수집 어레이와 원격 레이더 전방에 적합하다.
- 대역폭 천장: 단일 1080p60, 다채널 SDR IF, 또는 합쳐진 레이더 IQ는 10 Gb/s를 넘는 경우가 많아 기가비트 구리와 백플레인이 carry 못 하므로 SFP+(10G) 또는 QSFP28(25G/100G)이 필요하다.
- 타이밍·노이즈 내성: 노이즈가 많은 산업 환경에서 광은 전기적 절연, 크로스토크·접지 루프 내성을 제공하고 노드 간 공통 타이밍을 더 안정화한다.
전형적인 패턴: 원격 수집 카드는 ADC 샘플링과 전처리만 하고, 결과를 패킹해 광 한 가닥으로 중앙 서버에 보내면, 서버는 채널을 개별 처리하지 않고 집계 스트림만 받는다. 여기서 링크 라이트 레이트와 프로토콜 오버헤드가 달릴 수 있는 노드 수를 직접 결정한다.
2. 10G/25G 라이트 레이트와 UDP 페이로드 예산 (페이로드부터 계산)
많은 이가 “10 Gb/s 포트”를 사용 가능 대역폭으로 오해하지만, 애플리케이션 계층에 닿는 것은 인코딩·인터프레임 갭·프로토콜 헤더를 거친 뒤의 페이로드다. 라이트 레이트가 어떻게 생기는지부터 보자:
| 항목 | 10G (SFP+) | 25G (QSFP28) | 비고 |
|---|---|---|---|
| 명목 이더넷 레이트 | 10.0 Gb/s | 25.0 Gb/s | 유효 MAC 레이트 |
| 64b/66b 인코딩 후 라이트 레이트 | 10 × 66/64 = <span class=”hl”>10.3125 Gb/s</span> | 25 × 66/64 = <span class=”hl”>25.78125 Gb/s</span> | 물리 선로 위의 실제 비트 레이트 |
| MTU 1500 프레임 오버헤드 | 프리앰블/SFD 8B + 갭 12B + Eth 14B + IP 20B + UDP 8B | 동일 | 프레임당 비페이로드 약 62B |
| UDP 페이로드 비율 | 1500/(1500+62) = <span class=”hl”>96.03%</span> | ≈96.03% | 애플리케이션 계층 재전송은 미포함 |
| UDP 페이로드 레이트 (MTU1500) | 10 × 96.03% ≈ <span class=”hl”>9.60 Gb/s</span> | 25 × 96.03% ≈ <span class=”hl”>24.0 Gb/s</span> | 앱 계층이 실제로 받는 것 |
| 점보 프레임 (9000B) 비율 | 9000/9062 = 99.32% | 99.32% | 페이로드를 ~9.93 / ~24.8 Gb/s로 상승 |
핵심 결론: MTU1500 UDP에서 10G 포트는 앱에 10 Gb/s가 아니라 약 9.6 Gb/s만 준다. 노드 사이징은 페이로드로 하라: 노드당 유효 데이터 2 Gb/s를 보낸다면, 10G 링크 하나가 여유 있게 4~5 노드(9.6 / 2, 마진 포함)를 버티며, 꽉 찬 5개가 아니다. 라이트 레이트에 가깝게 가려면 점보 프레임을 활성화해 프레임당 고정 오버헤드를 상각시켜라.
BER과 링크 버짓
광 링크는 꽂으면 끝이 아니라 먼저 광 전력 버짓을 계산한다: 송신 전력 − 수신 감도 = 링크 마진, 여기서 광 감쇠(단일모드 1310 nm ≈ 0.35 dB/km)와 접속/커넥터 손실(커넥터당 약 0.5 dB)을 차감한다. SR 멀티모드 850 nm는 거리와 OM3/OM4에 제약되고, LR 단일모드 1310 nm는 10km에 다다른다. 적합한 링크는 BER 1e-12 이하를 목표로 하며, 25G는 보통 RS-FEC 순방향 정정을 더해 원시 1e-5 오류를 1e-15로 정정하므로, FEC 코딩 게인을 예산에 포함한다.
3. FPGA가 일을 나누는 방식
1. GTX/GTH 트랜시버가 광 모듈을 구동
Series-7 GTX는 10.3125 Gb/s에서 끝나 SFP+ 10G에 맞고, UltraScale/UltraScale+ GTH/GTY는 16G 이상으로 돌아 25G를 지원한다. 트랜시버가 시리얼라이즈/디시리얼라이즈, 8b/10b 또는 64b/66b 인코딩과 클록 복원을 담당하고, 외부에는 고속 페어와 모듈 I2C 관리(DDM 판독)만 남는다.
2. MAC과 프레임 처리
트랜시버 위에 10G/25G 이더넷 MAC이 자리한다: 프레임 구분, CRC 검사, PAUSE 흐름 제어. Rx는 CRC 불량 프레임을 버리고 목적지 MAC으로 필터링하며, Tx는 프레임을 캡슐화하고 갭을 채운다. 이 계층은 결정론적 파이프라인으로 풀하드웨어에 적합하다.
3. UDP 오프로드 엔진
CPU가 프레임마다 IP/UDP를 패킹하면 10G에서 병목이 된다. 온칩 오프로드: 하드웨어가 송수신 IP, 포트, 체크섬을 채우고, 사용자는 페이로드만 DMA 버퍼에 쓰면 엔진이 Eth/IP/UDP 헤더를 추가하고 체크섬을 계산해 MTU로 분편한다. CPU는 패킹하지 않고 초기화 시 주소 테이블만 한 번 구성한다—이것이 프로토콜 스택 오프로드다.
4. 오류 통계와 링크 모니터링
온칩 카운터가 CRC 오류, 버려진 프레임, FEC 정정을 집계해 관리 채널로 주기 보고하고, 모듈 DDM의 Tx 광전력, Rx 광전력, 온도도 수집해, 마진이 떨어지면 깨진 화면을 기다리지 않고 조기에 경보한다.
4. 엔지니어링 사례: 다중 노드 수집을 10G 광으로 백홀
분산 수집 시스템에 원격 노드 4대가 있다; 각각 SDR IF 채널 2개와 영상 채널 1개를 합쳐 약 2.2 Gb/s 유효 백홀을 만든다. 센터는 10G 광 한 가닥으로 집계하며, 점보 프레임 시 페이로드가 ~9.9 Gb/s라 4노드 합계 8.8 Gb/s에 마진이 남는다. 모든 프로토콜은 FPGA에서 UDP 오프로드되고 호스트는 페이로드만 받는다.
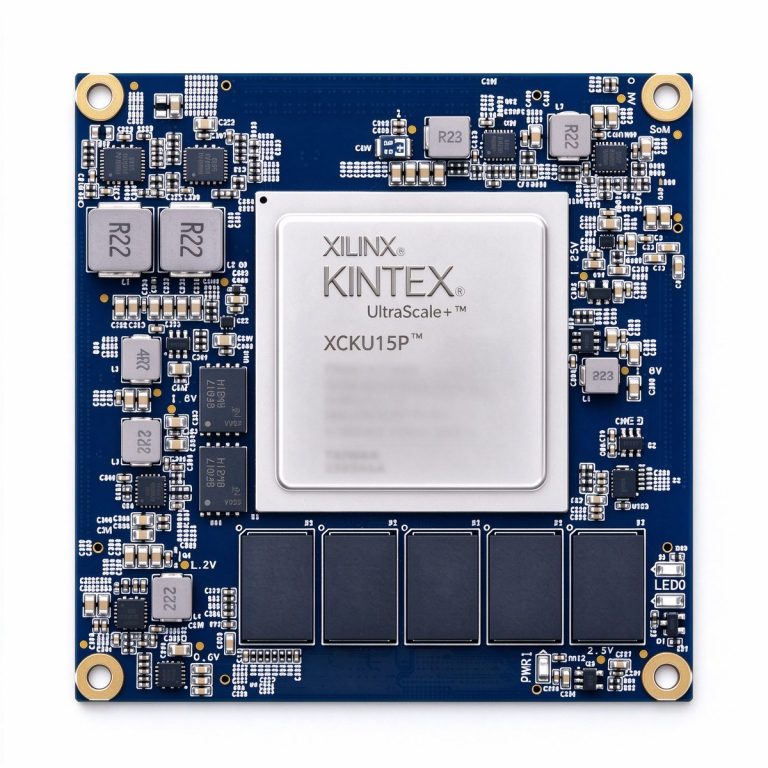
- 고대역폭 링크 (XCKU15P / Kintex UltraScale+): 25G 또는 다중 10G 레인에 넉넉한 GTY 트랜시버 마진, 25G/100G로 확장할 수 있는 메인 집계 노드에 적합.
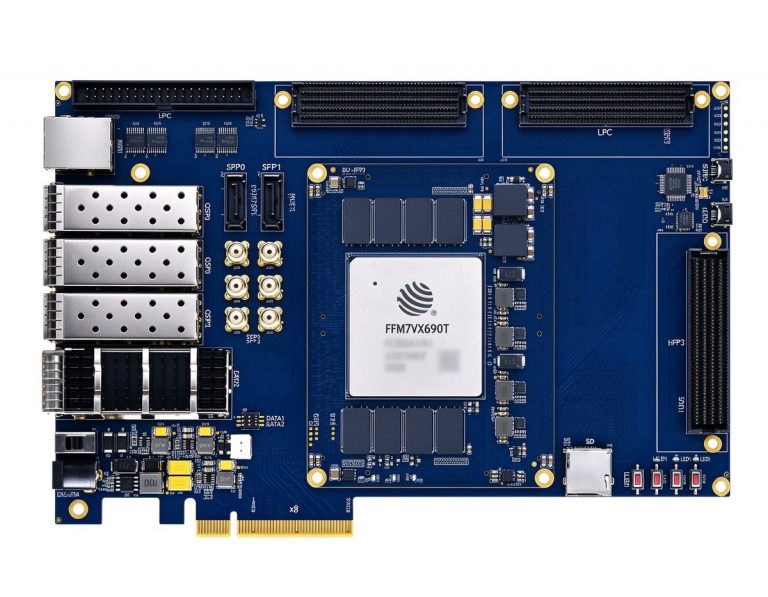
- 고용량 집계 (DUF7690T / JFM7VX690T): 여러 MAC, UDP 오프로드 엔진, 대형 큐에 충분한 로직과 온칩 RAM, 중앙 다중 노드 집계와 라이트 레이트 포워딩에 적합.
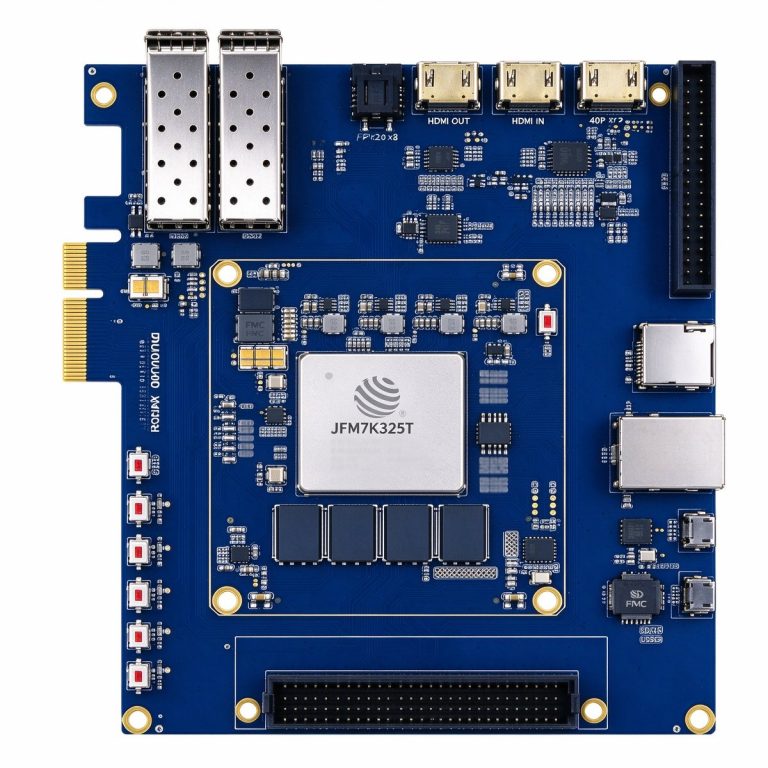
- 10G 프로토타입 엔트리 (DUK7325T / JFM7K325T): Series-7 GTX가 균형 잡힌 비용으로 10G 라이트 레이트를 포화, 단일 노드 10G 프로토타입과 엔트리 제품에 적합.
광 백홀은 본질적으로 FPGA의 트랜시버와 하드웨어 스택이 CPU를 대신해 “라이트 레이트 전송”을 끝내는 일이다. 두 숫자를 기억하라: MTU1500에서 10G는 ~9.6 Gb/s, 25G는 ~24 Gb/s 페이로드. 명목 레이트가 아니라 페이로드로 노드를 사이징하고, 링크 버짓과 BER를 앞서 계산하면 백홀이 현장에서 속도를 떨어뜨리지 않는다.