FPGA 실시간 산업용 비전 검사: GigE 카메라부터 불량 보정까지
생산라인 불량 검사 파이프라인을 따라 카메라 픽셀에서 리젝션 신호까지, FPGA가 대체 불가능한 지점은 도대체 어디일까? 이 글에서는 먼저 전체 데이터 흐름의 대역폭 예산을 계산한 뒤, 비전 파이프라인에서 FPGA가 담당하는 네 가지 역할을 분해하고, 전통 알고리즘과 딥러닝의 실시간 한계를 비교한 다음, 실제 PCB 납조 AOI 스테이션 사례를 통해 배치 가능한 하드웨어 선택까지 제시한다.
1. 먼저 대역폭 장부: 1080p60 라인의 데이터 흐름
산업용 비전에서 첫 번째 관문은 알고리즘이 아니라 대역폭이다. 가장 평범한 라인 구성—1080p, 60fps GigE Vision 카메라 1대—부터 시작해 데이터 레이트를 계산해 보자:
| 출력 포맷 | 계산식 | 결과 | 기가비트 링크로 감당 가능한가 |
|---|---|---|---|
| 8-bit Bayer (가장 일반적) | 1920 × 1080 × 8 bit × 60 | ≈ 995 Mb/s ≈ 124 MB/s | 1 Gbps의 99.5%를 점유, 간신히 |
| 12-bit Bayer (HDR/저조도) | 1920 × 1080 × 12 bit × 60 | ≈ 1.49 Gb/s ≈ 187 MB/s | 기가비트 초과; 2.5G/10G 또는 CoaXPress 필요 |
| 8-bit 카메라 4대 | 995 Mb/s × 4 | ≈ 4 Gb/s ≈ 500 MB/s | 4× 기가비트 집계 또는 10G 업링크 필요 |
이 원본 프레임을 통째로 CPU나 GPU로 보낸다면, 채널마다 초당 124~187 MB를 밀어 넣는 셈이고 4채널이면 500 MB/s다. CPU 측에서는 여전히 전체 프레임을 처리해야 해 양쪽 끝에서 대역폭과 연산을 동시에 태운다. 불량 검사에 실제로 필요한 것은 “이상 위치, 종류, 좌표”뿐인데, 흔히 수백 바이트에 불과하다.
핵심: 픽셀을 어디서 처리하느냐가 파이프라인 전체 비용을 결정한다
원본 프레임을 다른 곳으로 옮겨 처리하는 것은 “운반” 사고방식이고, 픽셀이 흘러가는 자리에서 바로 처리하는 것은 “파이프라인” 사고방식이다. 전자는 카메라가 늘 때마다 채널 하나분의 대역폭과 연산을 추가로 태우고, 후자는 처리 로직만 추가한다.
2. 비전 파이프라인에서 FPGA의 네 가지 역할
역할 1: 인터페이스 초기화와 다중 카메라 동기화
GigE Vision / CoaXPress 프로토콜 파싱, 카메라 파라미터 설정, 트리거 관리는 FPGA의 MAC 계층과 트리거 로직이 직접 담당한다. 여러 대의 카메라가 동일한 하드웨어 트리거 클록에 록되어, 다른 시점에서 들어오는 프레임이 같은 순간에 노광되도록 보장한다—소프트웨어로는 결정론적으로 따라하기 어려운 수준이다.
역할 2: 영상 전처리 (노이즈 제거, 게인, Bayer 보간)
노이즈 제거, 화이트 밸런스, 게인, Bayer 보간, ROI 추출—모두 픽셀 단위 연산이다. FPGA 파이프라인은 자연스럽게 클록 사이클당 픽셀 하나씩 진행되며, 1080p60의 픽셀 클록은 약 148.5 MHz로 JFM7K410T 같은 디바이스의 타이밍 마진 안에 충분히 들어온다. 동일한 픽셀 단위 작업을 CPU에서 하면 프레임당 수 ms~수십 ms의 루프가 걸리지만, FPGA에서는 수십 클록 사이클의 고정 지연으로 끝난다.
역할 3: 불량 검출 (템플릿, 차분, 연결 성분)
템플릿 매칭, 프레임 차분, 임계값 처리, 연결 성분 분석, 형태학 처리—모두 병렬화되고 파이프라인화 가능하다. FPGA에서 1080p 이미지의 템플릿 매칭은 프레임당 1 ms 이내로 돌며, 지연이 프레임 레이트와 무관하게 완전히 결정론적이다—라인 사이클 타임에 대한 하드 요건이다.
역할 4: 결과 출력과 IO 협조
판정 결과는 리젝션 액추에이터, 경고등, 통계 카운터를 직접 구동한다. FPGA GPIO 출력 지연은 나노초 스케일이며 OS, 드라이버, 애플리케이션 계층을 우회한다. 불량 프레임이 나타나는 순간, 리젝션 신호는 이미 액추에이터에 도착해 있다.
3. 두 가지 알고리즘 경로: 전통 비전 vs 딥러닝
최근 비전 프로젝트에서는 “딥러닝만 넣으면 된다”가 하나의 수식어처럼 굳어졌지만, 두 경로의 실시간 경계는 명확하게 그어야 한다:
| 구분 | 전통 비전 (템플릿/차분/형태학) | 딥러닝 (CNN/YOLO 계열) |
|---|---|---|
| 1080p 단일 프레임 지연 | <1 ms (FPGA 파이프라인) | 2–10 ms (GPU) 또는 그 이상 (범용 NPU) |
| 리소스 점유 | LUT/DSP 수량이 적음 | 무거운 DSP + 외부 메모리 대역폭 |
| 해석 가능성 | 임계값 조절 가능, 불량 추적 용이 | 블랙박스, 오검출 위치 파악 어려움 |
| 적합 용도 | 고정된 불량 패턴, 빠른 사이클 라인 | 복합 불량, 다양한 샘플의 오프라인 재검사 |
| FPGA 구현 | 성숙, 고도로 공학화됨 | 양자화/프루닝 필요; 보통 CPU/GPU에서 |
2026년 주류 라인 아키텍처는 FPGA 전처리 + 전통 방식 실시간 판정 + 딥러닝 오프라인 재검증이다. FPGA가 사이클 타임 내 판정과 리젝션을 보장하고, 딥러닝은 의심 영역에 대해 2차 확인을 수행하며—각자 잘하는 일을 하는 구조다.
4. 실제 사례: PCB 납조 AOI 스테이션
엔지니어링 사례 · 01: SMT 라인 납조 검사—60 fps 연속, 오검출률 < 0.5%
SMT 라인 AOI 스테이션은 냉납, 브릿지, 부품 누락을 검출해야 하고 60 fps로 연속 구동하며, 오검출 목표는 0.5% 미만, 냉납 누락률은 1% 미만이다.
- 카메라: GigE 20 MP 산업용 카메라 2대, 실제로는 1080p ROI로 크롭, 8-bit Bayer 출력
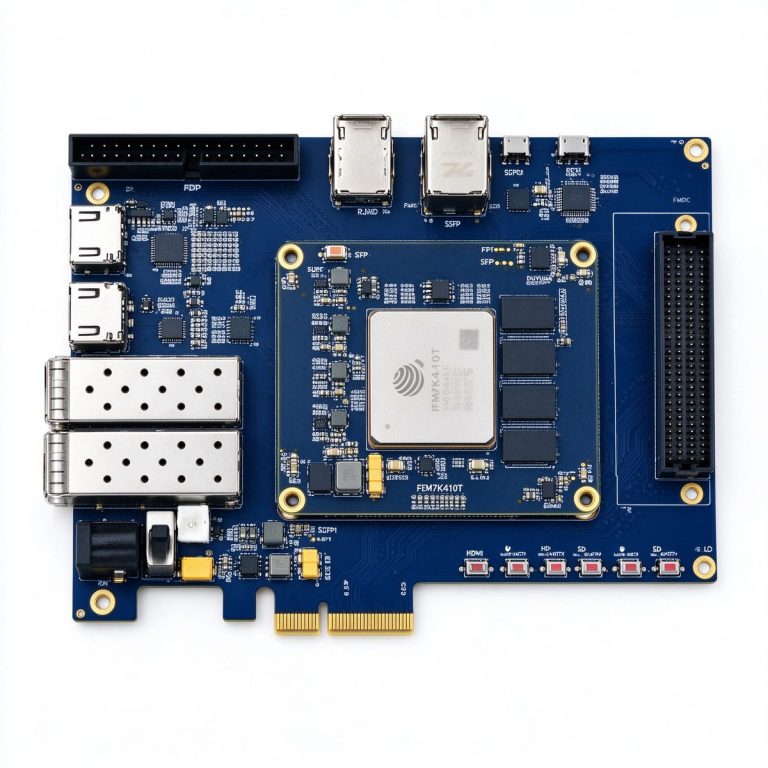
- 보드: DUK7410T (Fudan Micro JFM7K410T, 406K 로직 셀, FMC HPC, 4 GB DDR3)
- 데이터 흐름: 2 × 995 Mb/s ≈ 2.5 Gb/s를 FPGA로 → DDR 프레임 버퍼 → 템플릿 차분 + 연결 성분 분석 → 판정 출력
측정 결과: 단일 프레임 처리 < 0.8 ms; 카메라 트리거부터 리젝션 출력까지 종단간 지연 < 1.5 ms; 오검출률 < 0.5%; 냉납 검출률 > 99%.
CPU 기준선 대비: 종단간 지연이 약 15 ms에서 < 1.5 ms로, 호스트 CPU 부하가 85%에서 5%로 떨어졌다—기존 소프트웨어 파이프라인은 30 fps밖에 내지 못했으며, FPGA 전환으로 처리량이 2배가 되었다.
이 스테이션의 핵심은 화려한 알고리즘이 아니라 검사 동작이 라인 사이클을 따라가는 것이다. 불량 프레임이 도착하는 순간, 다음 프레임이 오기 전에 판정과 리젝션을 마쳐야 한다.
5. 하드웨어 선택법: 보드 3종, 전략 3가지
선택은 세 가지 질문을 따른다: 카메라가 몇 대인가? 지연 요구가 얼마나 빡빡한가? 머신 총예산은 얼마인가? 여기 Duyuante의 대표 플랫폼 세 가지를 제시한다:
DUK7410T (¥9,999)—미드레인지 실무형, 1/2카메라 AOI 표준 선택
Fudan Micro JFM7K410T, 406K 로직 셀, 1,540 DSP, FMC HPC, HDMI 4K 입력, 2× SFP+. FMC HPC는 고속 카메라 또는 ADC 메자닌에 직접 연결되고, HDMI 4K 입력은 디스플레이 루프백으로도 겸용 가능하다. 비전 포지셔닝, 불량 검출, 다채널 스티칭 프로토타입—대부분의 프로젝트는 여기서 시작한다.
PBC7K325G (¥1,999)—비용에 민감한 임베디드 머신 통합
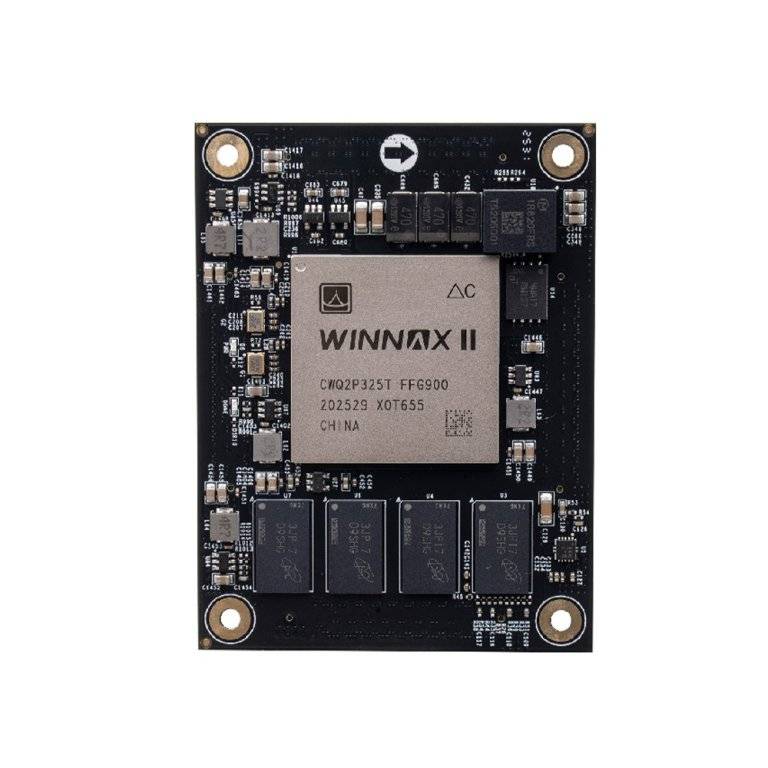
중국 Kintex-7 아키텍처 SoM, 326K 로직, GTX 트랜시버 16개, 2 GB DDR3, 산업용 등급 −40~85 °C. 단일 카메라 고정 패턴 임베디드 검사, 또는 비전+모션컨트롤 복합 컨트롤러. 비용에 민감한 제품은 여기서 출하한다.
DUF7690T (¥24,999)—다중 카메라 어레이와 고성능 복합 시스템
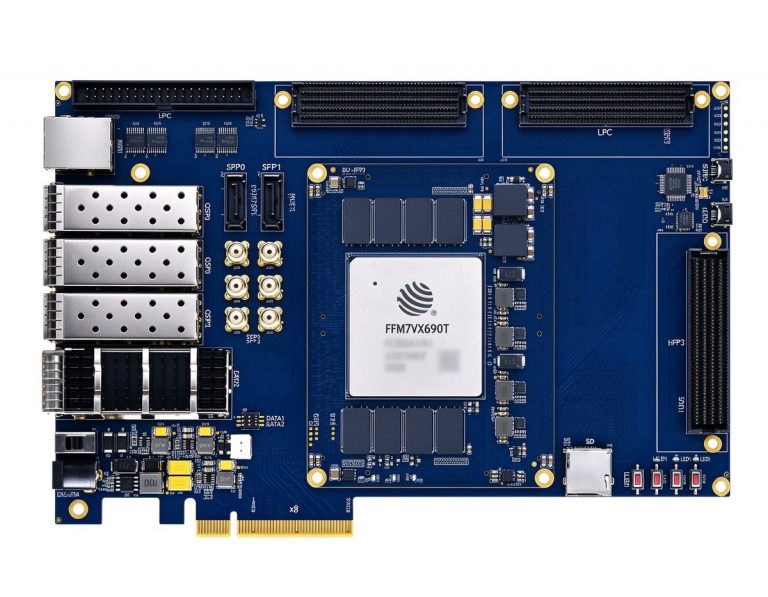
Fudan Micro JFM7VX690T, 693K 로직 셀, 3,600 DSP, 36 GTH 페어, QSFP 40G. 8대 이상 카메라 어레이, 8K 스티칭, 또는 비전+광통신 복합 시스템—큰 로직과 큰 대역폭이 필요할 때 이 보드로 올라선다.
산업용 비전의 제1원칙은 “프레임을 통째로 실어 나르지 말 것”이다—픽셀이 흘러가는 자리에서 처리하면, 지연과 대역폭, 전력 문제가 한 번에 해결된다.
— Duyuante 연구개발팀