PCIe 대역폭 설계: Gen3 x4~x16에서 실제 얻을 수 있는 순대역폭은?
PCIe 대역폭 장부는 데이터시트의 숫자보다 훨씬 복잡하다—원대역폭, 인코딩 오버헤드, 프로토콜 오버헤드, DMA 효율, DDR 병목이 그 “16 GB/s”을 각각 갉아먹는다. 이 글에서는 Gen3 x4/x8/x16을 DDR과 DMA 매칭까지 단계별로 풀어, 순대역폭을 추정하는 재사용 가능한 방법을 제시한다.
1. 대역폭의 세 단계: 원본, 인코딩 후, 순사용
스펙시트에서 “PCIe Gen3 x16″을 보면 직관적으로 16 GB/s라 생각한다. 그 숫자는 사실 원본 비트 레이트이지, 시스템에서 실제 쓸 수 있는 대역폭이 아니다. 그 사이에 두 단의 손실이 끼어 있다:
| 단계 | Gen3 x16 계산식 | 결과 | 의미 |
|---|---|---|---|
| ① 원본 비트 레이트 | 16 레인 × 8.0 GT/s | 128 Gb/s | 링크 상의 원본 심볼 레이트 |
| ② 인코딩 후 대역폭 | 128 × 128/130 (Gen3는 128b/130b 사용) | ≈ 126 Gb/s ≈ 15.75 GB/s | 인코딩 오버헤드를 뺀 페이로드 데이터 레이트 |
| ③ 실제 순대역폭 | 15.75 × 전송 효율 (80%–90%) | ≈ 12.6 – 14.2 GB/s | TLP 헤더, DMA 디스크립터, 인터럽트를 뺀 실사용 대역폭 |
Gen3은 레인당 8.0 GT/s로 128b/130b 인코딩 오버헤드가 1.5%에 불과하다—그래서 Gen3가 Gen2(8b/10b 오버헤드 20%)보다 훨씬 효율적이다. 폭별 비교:
| PCIe 폭 | 원본 비트 레이트 | 인코딩 후 대역폭 | 일반적 순대역폭 (대블록 DMA) |
|---|---|---|---|
| Gen3 x4 | 32 Gb/s | ≈ 3.94 GB/s | ≈ 3.2 – 3.5 GB/s |
| Gen3 x8 | 64 Gb/s | ≈ 7.88 GB/s | ≈ 6.3 – 7.1 GB/s |
| Gen3 x16 | 128 Gb/s | ≈ 15.75 GB/s | ≈ 12.6 – 14.2 GB/s |
| Gen2 x8 (참고) | 40 Gb/s | ≈ 4.0 GB/s (8b/10b) | ≈ 3.2 – 3.6 GB/s |
2. 프로토콜 오버헤드는 얼마나 될까: TLP, 페이로드, 읽기 vs 쓰기
인코딩 후 대역폭이 곧 순대역폭은 아니다. 모든 PCIe 트랜잭션 계층 패킷(TLP)은 12~20 바이트 헤더를 carrying하며, 페이로드가 클수록 헤더 비중이 작아져 효율이 높아진다.
페이로드 크기가 효율을 직접 결정한다
| 페이로드 크기 | TLP 헤더 비중 | 전송 효율 | 일반적 상황 |
|---|---|---|---|
| 4 KB (최대) | ≈ 0.4% | ≈ 90%+ | 대블록 연속 DMA 수집, 영상 스트림 |
| 512 B | ≈ 3% | ≈ 85–88% | 일반 데이터 반송 |
| 64 B | ≈ 25% | ≈ 55–65% | 레지스터 읽기/쓰기, 소패킷 제어 |
읽기가 쓰기보다 느리다: Completion의 숨은 비용
PCIe 쓰기는 fire-and-forget이라 송신측이 확인응답을 기다리지 않는다. PCIe 읽기는 Completion TLP가 돌아올 때까지 기다려야 하는데—왕복으로 지연이 2배가 되고 대역폭을 잠식한다. 측정값:
- 대블록 순차 쓰기: 인코딩 후 대역폭의 88–92%
- 대블록 순차 읽기: 일반적으로 80–85% (Completion 큐잉, 오버헤드)
- 읽기/쓰기 혼합: 방향 전환 시 링크 스톨이 발생해 효율이 5–10% 추가 하락
엔지니어링 설계에서는 여유 마진을 두고 “순대역폭 = 인코딩 후 × 80%”의 보수적 추정치를 쓰며, 이상적인 90%+ 수치를 쓰지 않는다.
3. DDR이 진짜 천장이다
PCIe 링크가 빠르다고 시스템이 풀스피드로 도는 것은 아니다—FPGA를 드나드는 데이터는 DDR을 반드시 통과하며, DDR 대역폭이 가장 먼저 부딪히는 벽인 경우가 많다.
DDR 대역폭 계산법
DDR 대역폭 = 데이터 버스 폭 × 데이터 레이트 / 8. Duyuante의 주요 보드 기준:
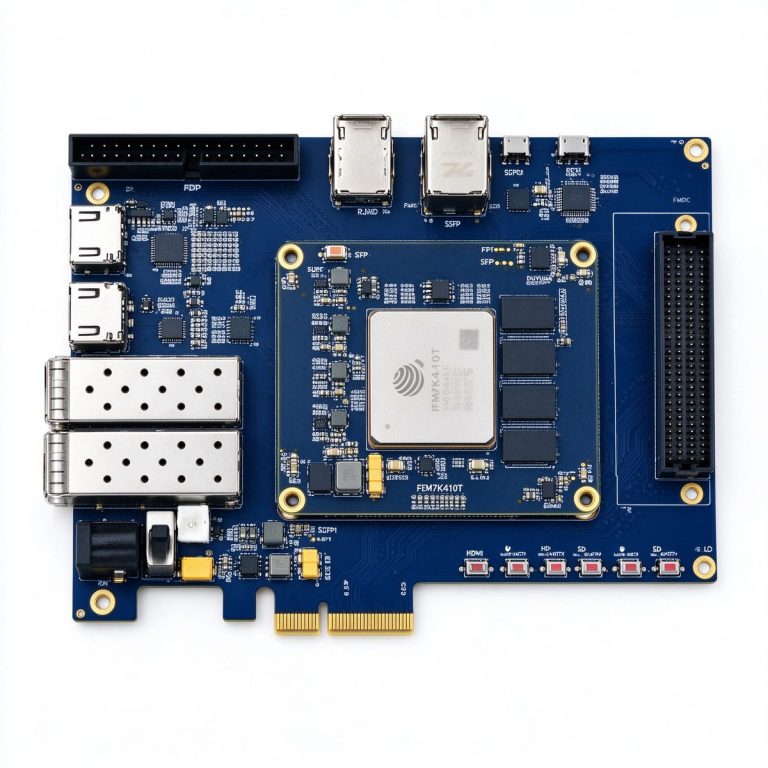
- DUK7410T: 4 GB DDR3, 64-bit 버스, 1866 Mbps → 64 × 1866 / 8 ≈ 14.9 GB/s
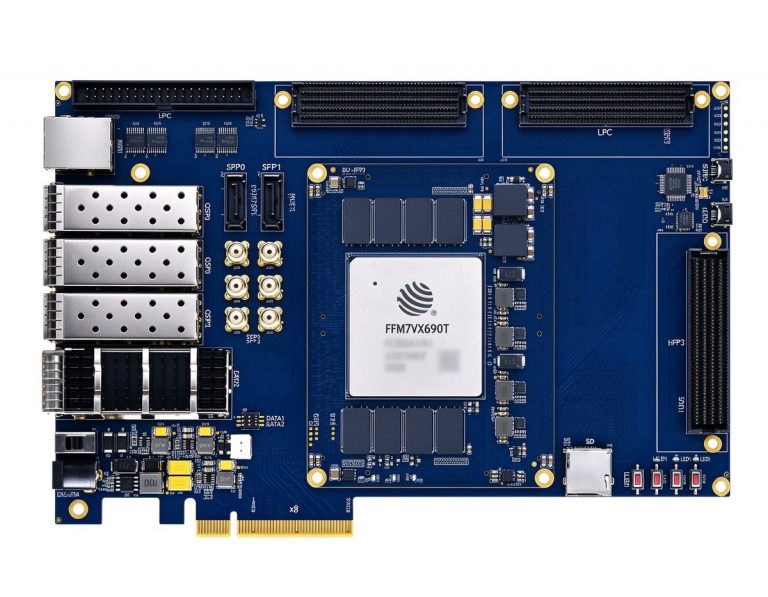
- DUF7690T: 4 GB DDR3, 64-bit, 1866 Mbps → ≈ 14.9 GB/s
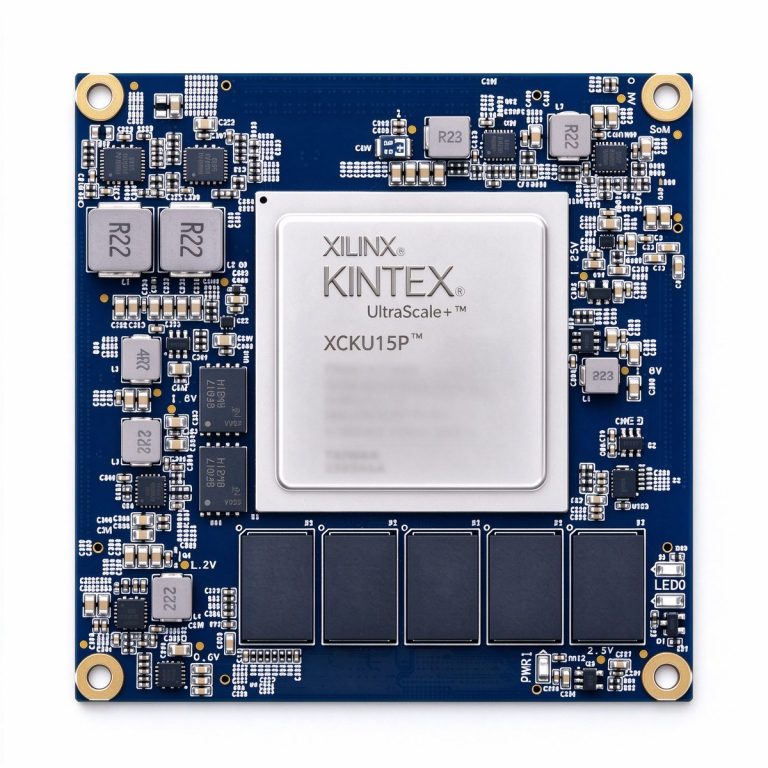
- DUKU15P: 8 GB DDR4 ECC, 64-bit 버스 (+8-bit ECC) → 2400 MT/s에서 ≈ 19.2 GB/s
데이터 흐름은 양방향: 읽기+쓰기로 부하가 2배
고속 수집 상황을 생각해 보자: ADC 데이터가 FPGA에서 처리된 뒤 PCIe로 호스트에 다시 쓰인다. 이 데이터 경로는 DDR을 두 번cross한다:
- FPGA 데이터 수신 → DDR 쓰기 (프레임 버퍼)
- FPGA 처리 완료 → DDR 읽기 (송신용 인출)
- DDR 총부하 = 쓰기 대역폭 + 읽기 대역폭
PCIe x8 Gen3 순대역폭이 7 GB/s라면, DDR은 동시에 7 GB/s 쓰기와 7 GB/s 읽기를 감당해야 해 = 14 GB/s—DDR3 물리 한계인 14.9 GB/s에 거의 육박해 FPGA 알고리즘 작업에 거의 남지 않는다. 이래서 x8 Gen3 + DDR3이 “황금 조합”이고, x16은 DDR4를 요구하는 것이다.
| 보드 | PCIe 사양 | 인코딩 후 대역폭 | DDR 구성 | DDR 대역폭 | 매칭 판정 |
|---|---|---|---|---|---|
| DUK7410T | Gen2 x8 | ≈ 4.0 GB/s | 4 GB DDR3 64-bit | ≈ 14.9 GB/s | PCIe가 병목, DDR에 여유 |
| DUF7690T | Gen3 x8 | ≈ 7.88 GB/s | 4 GB DDR3 64-bit | ≈ 14.9 GB/s | 방향당 ~7.5 GB/s, 딱 균형 |
| DUKU15P | Gen3 x16 | ≈ 15.75 GB/s | 8 GB DDR4 64-bit | ≈ 19.2 GB/s | PCIe 최대 부하 시 DDR이 한계에 근접 |
4. 3단계 추정: 프로젝트에 대역폭이 얼마나 필요한가
방법론 · 01: PCIe 대역폭 3단계 추정
1단계: 순수요구량 계산. 모든 데이터 소스의 원시 데이터 레이트를 합산한다—옮겨야 할 최소 볼륨이다.
2단계: 여유 계수 적용. 오버헤드, 버스트, 듀플렉스를 고려해 1.2~1.5배를 곱한다.
3단계: PCIe 폭 역산. 인코딩 후 대역폭 ≥ 여유 적용 요구량이 되는 사양을 고른 뒤, DDR이 따라오는지 검증한다.
세 가지 일반 시나리오로 검증했다:
| 시나리오 | 원시 데이터 레이트 | 여유 적용 후 요구량 | 권장 PCIe | 이유 |
|---|---|---|---|---|
| 고속 수집 (2ch × 250 MSPS × 14-bit) | ≈ 875 MB/s | ≈ 1.1 – 1.3 GB/s | Gen3 x4 (3.94 GB/s) | 여유 충분, DDR 부담 없음 |
| 4K60 영상 캡처 & 처리 (10-bit 4:2:2) | ≈ 1.5 GB/s | ≈ 1.8 – 2.3 GB/s | Gen3 x8 (7.88 GB/s) | 다채널 영상 또는 스티칭 여유 |
| AI 추론 피처맵 대량 반송 / 8K 영상 | ≈ 10 – 12 GB/s | ≈ 12 – 18 GB/s | Gen3 x16 (15.75 GB/s) | DDR4 필요, 그렇지 않으면 DDR이 먼저 벽에 부딪힘 |
경험칙: PCIe 폭을 고를 때는 순요구량 × 2로부터 역산하고, 배수 2의 여유를 통째로 남겨 두어라. 대역폭은 업그레이드할 수 있어도, 폭은 보드를 다시 설계하지 않으면 업그레이드할 수 없다.
5. Duyuante의 PCIe 플랫폼 3종 중 선택
DUK7410T (¥9,999)—비용 중시 수집 & 처리
Fudan Micro JFM7K410T, PCIe Gen2 x8 하드 IP, 인코딩 후 ~4 GB/s. FMC HPC 메자닌을 조합해 고속 ADC 수집이나 HDMI 4K 영상 처리용으로—PCIe 대역폭이 병목이 아닐 때 여기서 시작한다.
DUF7690T (¥24,999)—주류 수집 & 복합 처리
Fudan Micro JFM7VX690T, PCIe Gen3 x8 하드 IP, 인코딩 후 ~7.88 GB/s. 4 GB DDR3이 방향당 ~7.5 GB/s로 x8 풀대역폭에 매칭된다. 다채널 수집, 레이더 신호 처리, 영상 스티칭의 주류 플랫폼이다.
DUKU15P (¥15,999)—하이엔드 데이터 반송 & 100G 인터커넥트
AMD Kintex UltraScale+ XCKU15P, PCIe Gen3 x16 하드 IP, 인코딩 후 15.75 GB/s, 8 GB DDR4 ECC와 조합. 56개의 고속 트랜시버(24× GTY 28G + 32× GTH 16G)와 4× 100G 이더넷 하드 IP를 통합—대대역폭 PCIe 반송에 고속 네트워킹까지 얹은 플래그십 선택.
PCIe 대역폭은 결코 “인터페이스 스피드”가 아니라, “인터페이스 × 메모리 × DMA” 중 가장 짧은 보드다. DDR 여유부터 설계한 뒤에 PCIe 속도를 논하라.
— Duyuante 연구개발팀